2026-04-04 · อัปเดต 2026-07-28
AI Audio to Text: เวิร์กโฟลว์การถอดเสียงที่ใช้งานได้จริง
เปลี่ยนบทสัมภาษณ์ การโทร พอดแคสต์ และวิดีโอให้เป็นสคริปต์ที่พร้อมใช้ ด้วยเวิร์กโฟลว์ AI audio-to-text ที่ง่ายดาย พร้อมรายการตรวจสอบและตัวเลือกการส่งออก
อัปเดตล่าสุด: 28 กรกฎาคม 2026
การแปลงเสียง AI เป็นข้อความจะมีประโยชน์ก็ต่อเมื่อสามารถเชื่อถือถอดเสียงนั้นได้มากพอที่จะนำไปอ้างอิง ค้นหา ใส่คำบรรยาย หรือส่งมอบให้ลูกค้า ส่วนที่ยากไม่ใช่การกดอัปโหลด ส่วนที่ยากคือการบันทึกอินพุตที่สะอาด การเลือกเอาต์พุตที่ถูกต้อง และการตรวจสอบคำที่โมเดลอัตโนมัติมีแนวโน้มที่จะพลาดมากที่สุด
คำตอบสั้นๆ : วิธีการแปลงเสียงเป็นข้อความที่แม่นยำได้อย่างไร?
ใช้การบันทึกเสียงที่สะอาดที่สุดเท่าที่จะทำได้ อัปโหลดไฟล์เสียงต้นฉบับแทนการบันทึกหน้าจอแบบบีบอัด เปิดป้ายชื่อผู้พูดเมื่อมีคนมากกว่าหนึ่งคน จากนั้นตรวจสอบสคริปต์เทียบกับไฟล์เสียงก่อนเผยแพร่ เวิร์กโฟลว์การถอดสคริปต์ที่ดีควรผ่าน 4 ขั้นตอน: capture, transcription, cleanup, และ export
สำหรับการสรุปการประชุมสั้นๆ ไฟล์ TXT หรือ DOCX ก็เพียงพอแล้ว สำหรับวิดีโอ ให้ส่งออกเป็น SRT หรือ VTT เพื่อให้บรรทัดเหล่านั้นสามารถกลายเป็นคำบรรยาย (captions) ได้ สำหรับสายงานวิจัย ควรเก็บ timestamps และชื่อผู้พูดไว้เพื่อที่ว่าคำพูดต่างๆ จะสามารถตรวจสอบย้อนหลังได้
อย่าถือว่าการถอดสคริปต์ด้วย AI เป็นตัวแก้ไขขั้นสุดท้าย เพราะมันอาจพลาดชื่อผลิตภัณฑ์ สำเนียง เสียงรบกวนระหว่างพูด ข้อจำกัดความรับผิดชอบทางกฎหมาย และตัวเลข ให้สร้างขั้นตอนการตรวจสอบเฉพาะจุด (spot check) เข้าไปในกระบวนการ: ฟังนาทีแรก นาทีตรงกลาง และทุกส่วนที่มีชื่อ ราคา วันที่ หรือภาษาทางการแพทย์/กฎหมาย
ต้องเตรียมอะไรบ้างก่อนอัปโหลดไฟล์เสียง?
โดยปกติแล้ว การถอดเสียงที่ดีที่สุดมักจะเกิดขึ้นก่อนที่ไฟล์จะไปถึงเครื่องมือ AI โมเดลการพูดสามารถจัดการกับการหยุดชั่วคราวตามปกติและคำเติมได้ดี แต่ก็ยังประสบปัญหากับคลื่นเสียงที่ถูกตัด (clipped peaks), เพลงพื้นหลัง, ผู้พูดหลายคนทับซ้อนกัน, และไมโครโฟนที่คุณภาพต่ำทั่วห้องประชุม
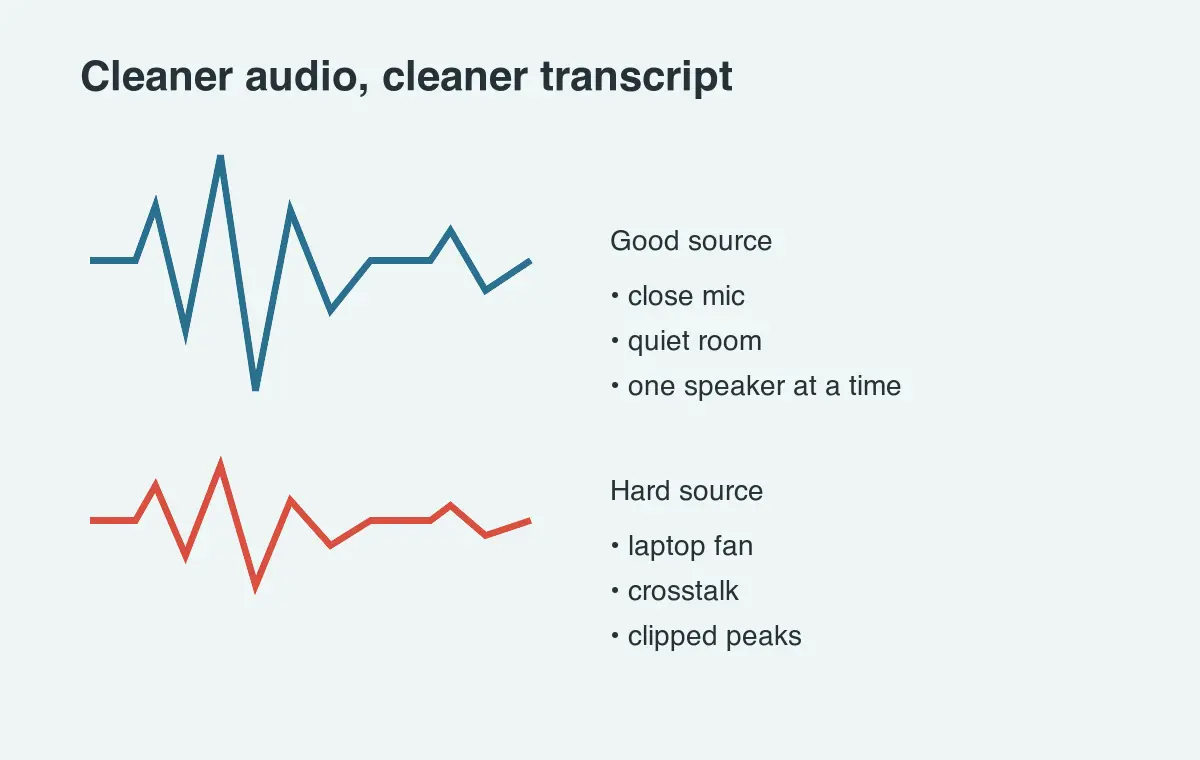
ใช้รายการตรวจสอบนี้ก่อนการทำพอดแคสต์ การสัมภาษณ์ เวบินาร์ หรือการโทรหาลูกค้า:
- บันทึกเสียงโดยให้ไมโครโฟนอยู่ใกล้ผู้พูด ไม่ใช่ข้ามห้อง
- ขอให้ผู้คนปิดการแจ้งเตือนและพัดลมแล็ปท็อปเมื่อทำได้
- บันทึกแทร็กแยกสำหรับพิธีกรและแขกรับเชิญ หากเครื่องมือของคุณรองรับ
- เก็บไฟล์ต้นฉบับที่เป็น WAV, M4A, หรือ MP3 บิตเรตสูงไว้จนกว่าจะมีการอนุมัติบทถอดความ
- ออกเสียงชื่อสำคัญอย่างช้า ๆ เพียงครั้งเดียวตั้งแต่เริ่มต้น โดยเฉพาะชื่อบริษัทและตัวย่อ
- หลีกเลี่ยงการใส่เพลงใต้คำพูดหากบทถอดความจะถูกนำไปใช้เป็นแคปชัน
- ทำเครื่องหมายส่วนที่ละเอียดอ่อนระหว่างการโทร เพื่อให้มีการตรวจสอบด้วยตนเองในภายหลัง
สำหรับการถอดเสียงที่ใช้บนเบราว์เซอร์ เอกสาร Web Speech API documentation ของ MDN เป็นเครื่องเตือนใจที่เป็นประโยชน์ว่าการรองรับและพฤติกรรมของการรู้จำคำพูดอาจแตกต่างกันไปในแต่ละเบราว์เซอร์ สำหรับงานระดับโปรดักชันหรือลูกค้า ควรหลีกเลี่ยงการพึ่งพาคุณสมบัติของเบราว์เซอร์เพียงอย่างเดียว เว้นแต่คุณได้ทดสอบบนอุปกรณ์ที่ทีมของคุณใช้
| ปัญหาแหล่งที่มา | สิ่งที่ทำกับการถอดเสียง | แก้ก่อนหรือระหว่างบันทึก |
|---|---|---|
| ผู้พูดไกลจากไมโครโฟน | คำกลายเป็นการเดา โดยเฉพาะตอนจบ | ขยับไมโครโฟนใกล้ขึ้นหรือใช้หูฟัง |
| สองคนพูดพร้อมกัน | ป้ายผู้พูดและการแบ่งประโยคล้มเหลว | หยุดและทำซ้ำคำตอบสำคัญ |
| เพลงพื้นหลังใต้เสียงพูด | คำบรรยายทิ้งคำสั้นและเครื่องหมายวรรคตอน | ส่งออกแทร็กเสียงพูดอย่างเดียว |
| พีคเสียงตัด | คำดังกลายเป็นเรื่องไร้สาระ | ลดอินพุตเกนและทดสอบ 20 วินาที |
| ศัพท์เฉพาะหรือชื่อมาก | คำนามเฉพาะถูกแทนที่ด้วยคำทั่วไป | เพิ่มอภิธานศัพท์หรือตรวจทานบรรทัดเหล่านั้นด้วยมือ |
การตั้งค่า AI audio-to-text ใดที่สำคัญ?
อินเทอร์เฟซการถอดเสียงส่วนใหญ่จะซ่อนรายละเอียดของโมเดล แต่การตั้งค่าที่ใช้งานจริงนั้นคล้ายกัน ให้เลือกตัวเลือกที่ช่วยรักษาบริบทสำหรับงานที่คุณต้องทำให้เสร็จ
| การตั้งค่า | ใช้เมื่อ | ข้ามเมื่อ |
|---|---|---|
| speaker labels | บทสัมภาษณ์, งานประชุม, การโทรขาย, พอดแคสต์ | ผู้บรรยายคนเดียวอ่านสคริปต์ |
| Timestamps | คุณต้องการคำพูดอ้างอิง คำบรรยาย หรือบันทึกแก้ไข | บทถอดเสียงมีไว้สำหรับบันทึกคร่าว ๆ เท่านั้น |
| Verbatim mode | การตรวจสอบทางกฎหมาย, การวิจัยความสามารถในการใช้งาน, คำพูดที่แม่นยำ | คุณต้องการร่างบทความที่อ่านง่าย |
| Auto punctuation | เกือบทุกกรณี | คุณวางแผนที่จะสร้างเครื่องหมายวรรคตอนด้วยตนเอง |
| Custom vocabulary | ชื่อผลิตภัณฑ์, ชื่อบุคคล, ชื่อยา, acronyms | เสียงที่บันทึกใช้ภาษาทั่วไป |
| Translation | คุณต้องการเอาต์พุตเป็นภาษาอื่นแยกต่างหาก | คุณต้องการเพียงการถอดเสียงในภาษาเดียวกันเท่านั้น |
หากเครื่องมืออนุญาตให้คุณระบุคำศัพท์เฉพาะ (glossary) ให้เพิ่มคำเหล่านั้นก่อนอัปโหลด รวมถึงการสะกดชื่อแบรนด์ ชื่อบุคคล SKU codes ชื่อฟีเจอร์ และ acronyms คำศัพท์เฉพาะอาจเป็นงานตั้งค่าที่น่าเบื่อ แต่ช่วยป้องกันข้อผิดพลาดที่เห็นได้ชัดที่สุด
สำหรับ pipeline ที่ใช้ API ให้ดู audio and speech guide ของ OpenAI ซึ่งบันทึกอินพุตและเอาต์พุต speech-to-text ทั่วไป แม้ว่าคุณจะใช้ผู้ให้บริการรายอื่น คำถามเชิงปฏิบัติเดียวกันก็ยังคงใช้ได้: รูปแบบไฟล์ใดที่ยอมรับได้, ว่ามี timestamps หรือไม่, ไฟล์สามารถยาวได้แค่ไหน, และมีการจัดการความเป็นส่วนตัวอย่างไร
ต้องทบทวนสคริปต์ที่สร้างโดย AI โดยที่ไม่ต้องอ่านซ้ำทั้งหมดได้อย่างไร?
ให้ทบทวนตามความเสี่ยง ไม่ใช่ตามจำนวนหน้า การสัมภาษณ์ที่สะอาดและใช้เวลาหนึ่งชั่วโมงสามารถได้รับการอนุมัติเร็วกว่าการโทรคุยกับลูกค้าที่วุ่นวายแค่สิบนาที หากการบันทึกเสียงยาวนั้นมีผู้พูดเพียงคนเดียวและไม่มีรายละเอียดที่ละเอียดอ่อน
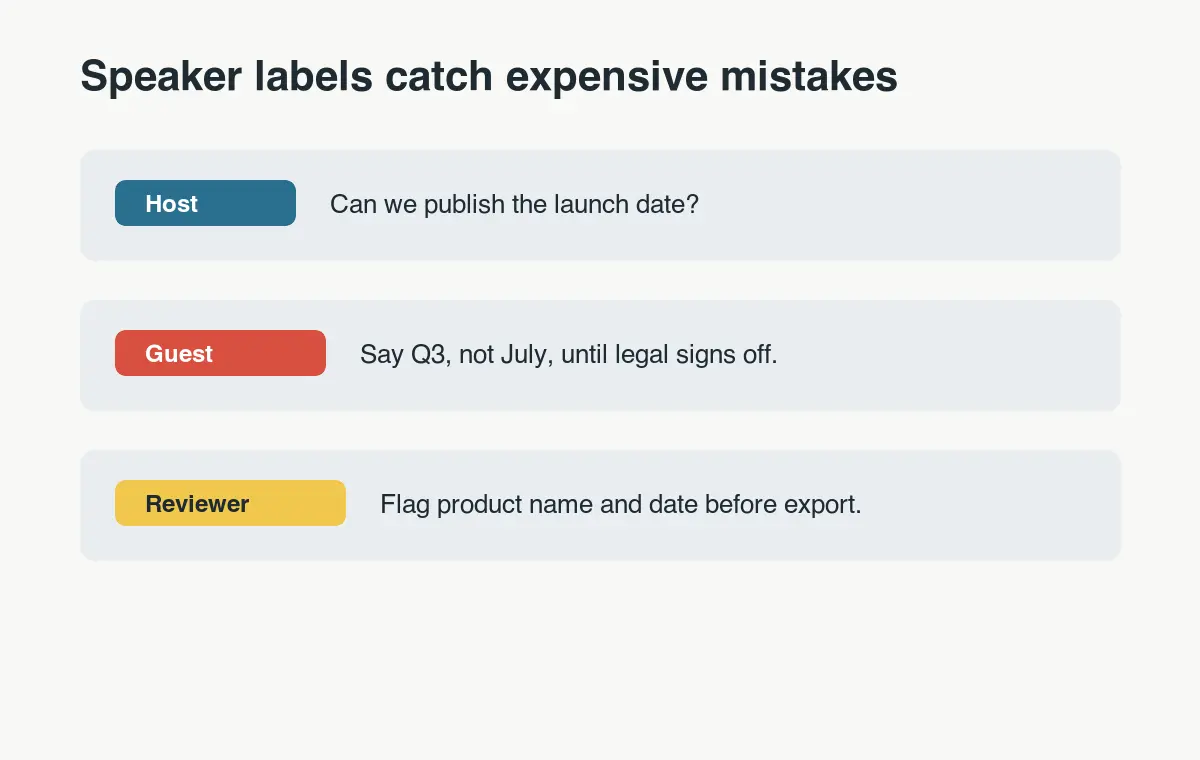
หากมีเวลาจำกัด ให้ใช้ลำดับนี้:
- ตรวจสอบนาทีแรกเพื่อยืนยันว่าเครื่องมือเข้าใจเสียงพูดหรือไม่
- ค้นหาคำว่า
[inaudible], ช่วงเวลาว่างเปล่า (blank timestamps), คำที่ซ้ำกัน และวลีที่ดูเหมือนการสร้างภาพหลอนอย่างชัดเจน - ทบทวนคำนามเฉพาะทุกคำ: บุคคล ผลิตภัณฑ์ เมือง บริษัท และชื่อไฟล์
- ทบทวนตัวเลขทุกตัว: ราคา วันที่ ปริมาณยา เปอร์เซ็นต์ หมายเลขโทรศัพท์ และเวลา
- ฟังส่วนที่มีผู้พูดสองคนทับซ้อนกัน
- เปรียบเทียบตอนจบ เนื่องจากคำกล่าวอำลา (sign-offs) มักจะรวมถึงขั้นตอนต่อไปและกำหนดเวลา
- ส่งออกสำเนาที่สะอาดก็ต่อเมื่อป้ายกำกับผู้พูดและช่วงเวลาเสถียรแล้วเท่านั้น
ประเด็นคือการจับข้อผิดพลาดที่เปลี่ยนความหมาย หากใครบางคนพูดว่า "ห้ามส่งร่างฉบับนี้" แต่สคริปต์ระบุว่า "ส่งร่างฉบับนี้" การขัดเกลารูปแบบยังไม่สำคัญ
สำหรับคำบรรยาย (captions) ให้ทบทวนการขึ้นบรรทัดใหม่แยกกัน WCAG 2.2 guidance for prerecorded captions ของ W3C อธิบายว่าทำไมข้อความที่ซิงโครไนซ์จึงสำคัญต่อการเข้าถึงวิดีโอ หากสคริปต์จะกลายเป็นคำบรรยายใต้ภาพ (subtitles) ทั้งจังหวะเวลาและความยาวของบรรทัดก็ต้องได้รับความสนใจเท่ากับตัวคำ
คุณควรเลือกรูปแบบการส่งออกใด?
ให้เลือกการส่งออกตามขั้นตอนการทำงานถัดไป ไม่ใช่จากนามสกุลไฟล์ที่คุณรู้จัก ทรานสคริปต์เดียวกันอาจต้องมีการส่งออกสองรูปแบบ: ไฟล์ DOCX ที่อ่านง่ายสำหรับลูกค้า และไฟล์ SRT สำหรับบรรณาธิการวิดีโอ
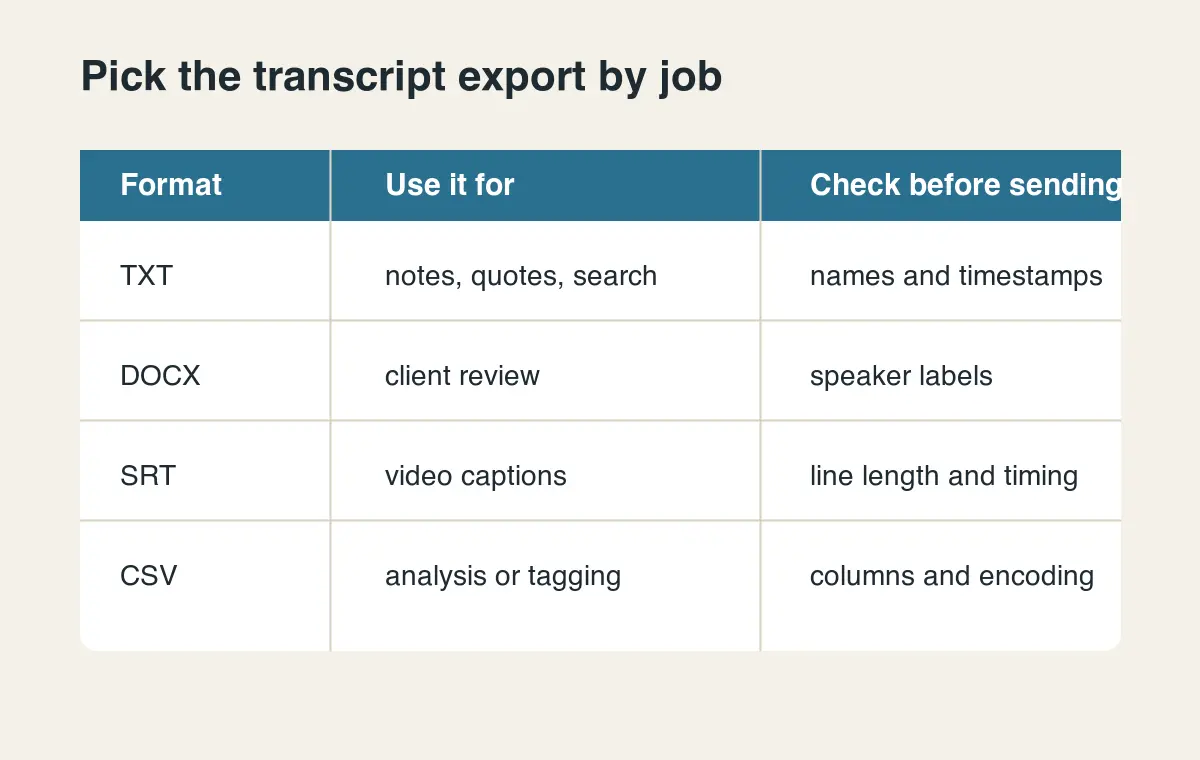
| ผลลัพธ์ | เหมาะกับ | ตรวจก่อนส่ง |
|---|---|---|
| TXT | โน้ตที่ค้นหาได้, คลังคำพูด, สรุป AI | ป้ายชื่อผู้พูดและตัวแบ่งย่อหน้า |
| DOCX | การตรวจสอบของลูกค้า, การแก้ไข, ความเห็นทางกฎหมาย | Track changes, headers, และ names |
| ทรานสคริปต์แบบอ่านอย่างเดียวที่ล็อกไว้ | Accessibility tags และ selectable text | |
| SRT | คำบรรยายวิดีโอและคลิปโซเชียล | Timing, line length, และ reading speed |
| VTT | คำบรรยายวิดีโอบนเว็บ | Cue timing และ browser/player support |
| CSV | การติดแท็กงานวิจัย, การวิเคราะห์, สเปรดชีต | Columns, encoding, และ timestamp format |
หากคุณกำลังเปลี่ยนทรานสคริปต์ให้เป็นโพสต์ ให้ใช้ทรานสคริปต์เป็นวัตถุดิบ จากนั้นเขียนใหม่สำหรับช่อง บทความที่ตรงตามตัวอักษรแทบจะไม่เหมาะกับการเป็นบทความบล็อก สำหรับขั้นตอนการเขียน AI content writing guide เป็นสิ่งที่ควรอ่านต่อไปที่ดีกว่าคู่มือสอนการถอดเสียงอีกครั้ง
สำหรับวิดีโอ ให้จับคู่ทรานสคริปต์กับ video subtitle guide สำหรับทีมพอดแคสต์ ให้ติดตาม AI podcast editing workflow โดยเฉพาะอย่างยิ่งหากคุณต้องการ show notes และคลิปจากบันทึกเสียงเดียวกัน
การถอดเสียงด้วย AI มีความเสี่ยงเมื่อใด?
การแปลงเสียง AI เป็นข้อความมักจะใช้ได้ดีสำหรับบันทึกภายใน บันทึกรายการ คลังข้อมูลที่ค้นหาได้ และคำบรรยายฉบับแรก แต่มีความเสี่ยงเมื่อข้อความถอดเสียงนั้นกลายเป็นหลักฐาน คำแนะนำทางการแพทย์ คำสั่งทางการเงิน หรือคำพูดสาธารณะที่อ้างถึงบุคคลใดบุคคลหนึ่ง
ให้ถือว่ากรณีเหล่านี้เป็นงานที่ต้องตรวจสอบด้วยตนเอง:
- การให้การทางกฎหมาย การสัมภาษณ์บุคลากร (HR) และสายเรียกเพื่อการปฏิบัติตามข้อกำหนด
- บทสนทนาทางการแพทย์ คำแนะนำผู้ป่วย หรือรายละเอียดปริมาณยา
- การประชุมรายงานผลประกอบการ การอัปเดตสำหรับนักลงทุน ราคา และข้อกำหนดสัญญา
- งานวิจัยลูกค้าที่คำพูดเพียงประโยคเดียวอาจเปลี่ยนการตัดสินใจเกี่ยวกับผลิตภัณฑ์ได้
- การสนทนาหลายภาษาที่ผู้พูดสลับภาษาในช่วงกลางประโยค
- คำบรรยายสาธารณะสำหรับวิดีโอเปิดตัว หลักสูตร และเว็บินาร์แบบเสียเงิน
เวิร์กโฟลว์ที่ปลอดภัยกว่านั้นง่ายมาก: สร้างฉบับร่างการถอดเสียง ตรวจสอบบรรทัดที่มีความเสี่ยงสูงเทียบกับไฟล์เสียง จากนั้นจึงส่งเฉพาะส่วนที่อนุมัติแล้วต่อไป หากคำพูดใดจะปรากฏในกรณีศึกษา โฆษณา หรือข่าวประชาสัมพันธ์ ให้ขอให้ผู้พูดอนุมัติประโยคที่แน่นอนนั้น
คุณจะนำสคริปต์ที่ผ่านการทำความสะอาดไปใช้ซ้ำได้อย่างไร?
สคริปต์ที่ผ่านการทำความสะอาดคือไฟล์ต้นฉบับ คุณสามารถนำมันไปสร้างเป็นเนื้อหาสำหรับค้นหา (search content), ข้อมูลสรุปงานออกแบบ (design briefs), คำบรรยายภาพ (captions), บทความสนับสนุน (support articles) และสินทรัพย์โซเชียล (social assets) โดยไม่ต้องเริ่มจากหน้ากระดาษเปล่า
เส้นทางการนำไปใช้ซ้ำที่เป็นประโยชน์:
- ดึงช่วงเวลาที่น่าอ้างถึง 3 ช่วงสำหรับร่างบล็อกหรือเรื่องราวของลูกค้า
- สร้างคำบรรยายภาพแบบ SRT สำหรับวิดีโอเต็มและคลิปสั้น
- สรุปการตัดสินใจและผู้รับผิดชอบจากการประชุม
- ดึงข้อโต้แย้งและความต้องการคุณสมบัติจากสายการขาย
- เปลี่ยนเวบินาร์ให้เป็นหน้า FAQ สำหรับการค้นหา
- ดึงข้อความสำหรับภาพขนาดย่อ (thumbnail) และตัวเลือกชื่อเรื่องสำหรับการอัปโหลดบน YouTube
หากสคริปต์กลายเป็นสื่อการตลาด ให้คงคำพูดที่ผูกติดกับเสียงต้นฉบับไว้จนกว่าจะได้รับการอนุมัติขั้นสุดท้าย สิ่งนี้ช่วยป้องกันความผิดพลาดทั่วไป: บทสรุปฟังดูขัดเกลาแต่กล่าวถึงสิ่งที่ผู้พูดไม่ได้ตั้งใจ
สำหรับสินทรัพย์ภาพที่สร้างจากบรรทัดสคริปต์ ให้ใช้ YouTube thumbnail maker guide หรือ social media image sizes guide เพื่อให้คำพูดเข้ากับรูปแบบปลายทาง สำหรับเนื้อหาช่วยเหลือที่ค้นหาได้, AI documentation guide เป็นขั้นตอนต่อไปที่ใช้งานได้จริงกว่า
เครื่องมือที่เกี่ยวข้อง: เครื่องมือเพิ่มข้อความบนภาพ
เครื่องมือที่เกี่ยวข้อง: เครื่องมือบีบอัดภาพ
ขั้นตอนการทำงานง่ายๆ สำหรับไฟล์ที่บันทึกเพียงครั้งเดียว
นี่คือกระบวนการที่ฉันใช้สำหรับการสัมภาษณ์ทั่วไป, พอดแคสต์, หรือการประชุมผลิตภัณฑ์ที่บันทึกไว้:
- บันทึกไฟล์เสียงต้นฉบับและตั้งชื่อโดยระบุวันที่ หัวข้อ และผู้พูด
- อัปโหลดไฟล์ต้นฉบับ ไม่ใช่การส่งออกวิดีโอที่ถูกบีบอัด
- เปิดใช้งานป้ายชื่อผู้พูดและเวลา (timestamps)
- เพิ่มคำศัพท์เฉพาะทาง (glossary) หากเครื่องมือรองรับคำศัพท์ที่กำหนดเอง
- สร้างบทถอดเสียง (transcript) และตรวจสอบความผิดพลาดเชิงโครงสร้าง
- ฟังนาทีแรก นาทีกลาง และทุกประโยคที่มีความเสี่ยง
- แก้ไขชื่อ ตัวเลข คำศัพท์ผลิตภัณฑ์ และการสลับผู้พูดที่ไม่ชัดเจน
- ส่งออกเป็น TXT สำหรับการค้นหา, DOCX สำหรับการตรวจสอบ, หรือ SRT/VTT สำหรับคำบรรยาย
- จัดเก็บบทถอดเสียงไว้ข้างไฟล์เสียงต้นฉบับ เพื่อให้สามารถติดตามการแก้ไขในอนาคตได้
- ลบไฟล์ที่อัปโหลดชั่วคราว หากนโยบายความเป็นส่วนตัวของคุณกำหนดไว้
ขั้นตอนสุดท้ายนี้เป็นสิ่งที่ง่ายที่จะลืม บทถอดเสียงมักมีข้อมูลที่ละเอียดอ่อนมากกว่าบทความหรือวิดีโอฉบับสมบูรณ์ เนื่องจากมีการรวมความคิดเห็นเสริม ชื่อ และรายละเอียดการวางแผนแบบร่างไว้ด้วย
เครดิตรูปภาพ
- ภาพปก, รายการตรวจสอบคุณภาพเสียง, การทบทวนป้ายชื่อผู้พูด, และกราฟิกรูปแบบการส่งออก ถูกสร้างขึ้นสำหรับบทความนี้เพื่อใช้เป็นภาพประกอบขั้นตอนการทำงานและแปลงเป็น WebP ภายใต้พาธ CDN ที่
ai-audio-to-text.
ใช้เครื่องมือฟรีของเราขณะทำตามคู่มือนี้
อ่านต่อ
2026-10-07
ตัดพื้นหลังกินส่วนของตัวแบบไปด้วย? วิธีแก้
เครื่องมือตัดพื้นหลัง AI ลบแขนและเสื้อผ้าสีอ่อน ราวแขวนสีขาว แสงสะท้อนบนแก้ว และเงา ผมวัดสาเหตุจากภาพจริง พร้อมวิธีกู้ส่วนที่หายไปกลับมา
2026-10-07
เปรียบเทียบตัวลบพื้นหลังเป็นชุด 2026: สำหรับอีคอมเมิร์ซ
เปรียบเทียบ PhotoRoom, remove.bg และ Pixelcut สำหรับการลบพื้นหลังเป็นชุดสำหรับอีคอมเมิร์ซ ปี 2026: ราคา ขีดจำกัด คุณภาพขอบ และเครื่องมือที่เหมาะกับแคตตาล็อกของคุณ
2026-10-07
remove.bg ปิดตัว 1 ธันวาคม: ใช้อะไรแทนดี?
remove.bg ปิดให้บริการวันที่ 1 ธันวาคม 2026 และเครดิตที่ยังไม่ได้ใช้จะหมดอายุในวันเดียวกัน มีอะไรเปลี่ยน ต้องทำอะไรก่อน และทางเลือกฟรีแทนเว็บไซต์และ API